十月国产大模型上新潮,官方实锤的只有三款
十月的国产大模型圈子很热闹。一份“中国模型前瞻”清单在 X 上被大量转发,DeepSeek、智谱、月之暗面、阿里、腾讯、小米、MiniMax 七家厂商被写进同一张时间表。
但热闹归热闹,官方到底说了什么,和社区在传什么,中间隔着一条不小的鸿沟。
我们逐一核对了各家官网、API 文档和正式新闻稿,把“已确认”和“还在传”分开来看。
已经落地的:三款模型有实锤
MiniMax M3.1-Flash-Preview:预览版已可用,但“兔子”官方没认领
官方状态:已上线 MiniMax Code 和 M Plan,可调用。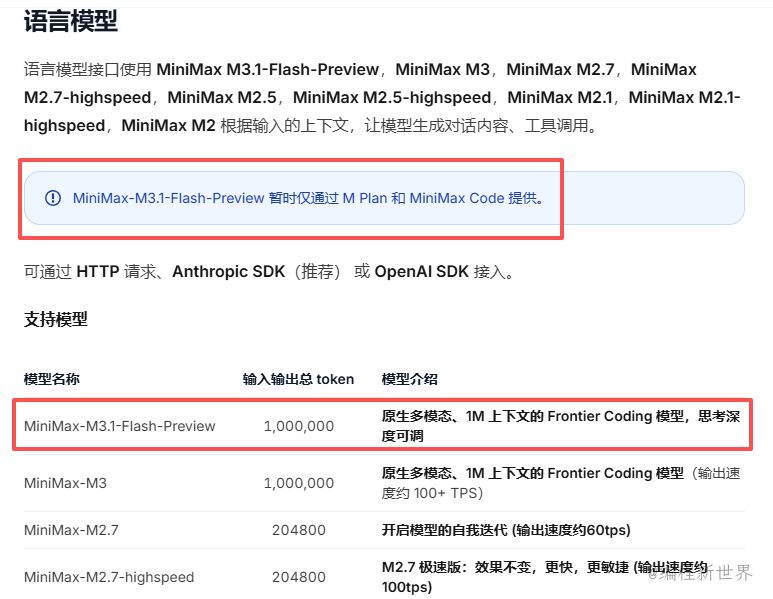
MiniMax 官方模型列表显示,M3.1-Flash-Preview 目前仅通过 M Plan 和 MiniMax Code 提供。它支持 100 万 token 上下文、原生多模态、五档可调思考深度(low/medium/high/xhigh/max,默认 max)。
它的来路也挺有意思。9 月 23 日起,OpenRouter 上挂着一个匿名模型 Space Bunny Alpha,主打推理极快、编程强、100 万上下文,免费调用。上线后迅速登上 OpenRouter 和 OpenCode 日调用量榜首。独立研究者做了 24 组 token 计数测试,发现 Space Bunny 与 MiniMax 模型的分词特征高度一致。
但 MiniMax 官方从未认领“Space Bunny”这个代号。 官方文档中只有 M3.1-Flash-Preview 的正式名称。目前该模型没有独立按量付费 API、没有完整模型卡、没有 benchmark,等待的是正式版发布和开放范围扩大。
小米 MiMo-V2.6 系列:已开源,训练过程全程公开
官方状态:已发布并开源,含 Pro 和 Flash 两个版本。
小米在 9 月 22 日发布了 MiMo-V2.6 系列并开源权重,包括旗舰 MiMo-V2.6-Pro 和高效推理模型 MiMo-V2.6-Flash,均采用 MIT 许可证。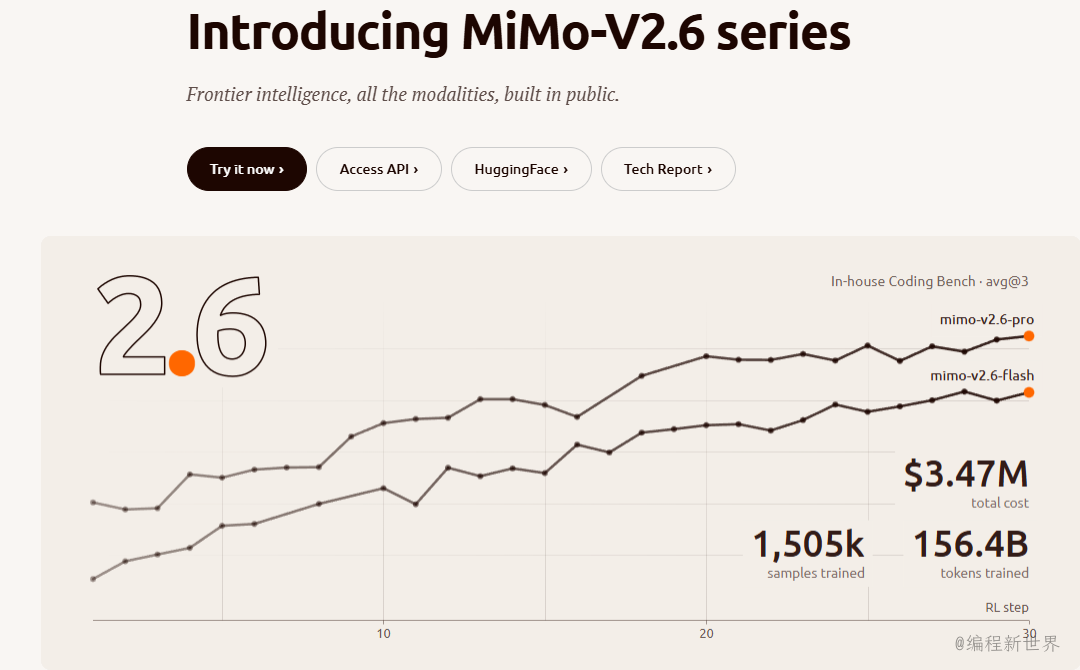
MiMo-V2.6-Pro 是 1.02 万亿参数的 MoE 模型,每 token 激活 420 亿参数,支持文本、图像、视频、音频输入,最高 100 万 token 上下文,输出最高 12.8 万 token。在 Artificial Analysis 智能指数上排名开源权重模型第一(46 分),超越了 Kimi K3 和 Qwen3.8-Max。
最特别的是小米的训练方式:以公开仪表盘直播 RL 训练过程,总花费约 350 万美元,并承诺陆续开源 7000 余个 RL 训练环境及完整训练框架。
关于 MiMo-V3:小米 MiMo 负责人罗福莉已在 9 月 24 日公开了下一代架构核心技术 HySparse2,称 MiMo-V3 将搭载这一全新自研架构。但 V3 本身的发布日期尚未官方确认,社区传闻为 10 月 23 日。
腾讯 Hy4:Preview 已开源,价格已公布
官方状态:Hy4 preview 已发布并开源。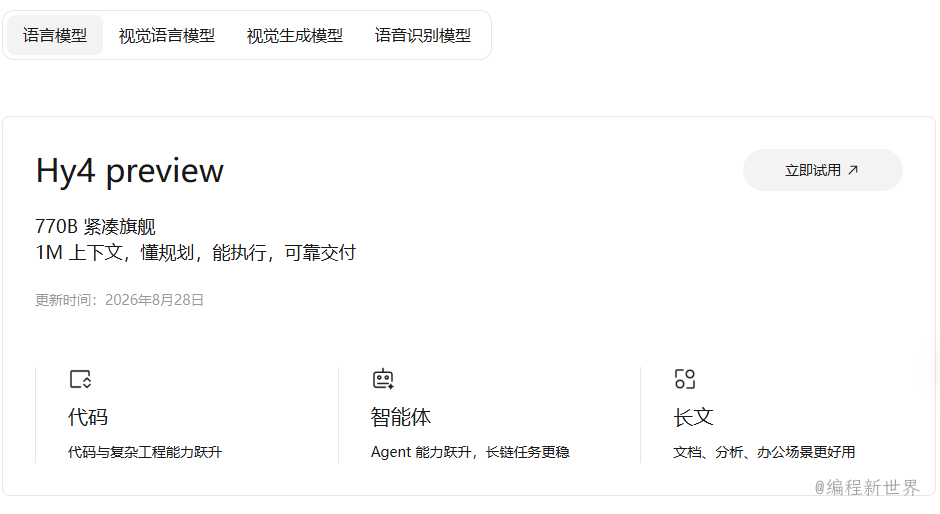
腾讯云 Token Plan 页面显示,Hy4 preview 总参数 770B、激活参数 49B,重点面向 Agent、Coding 与生产力场景优化。价格方面,每百万 tokens 输入 6 元、输出 18 元、缓存命中最低 0.3 元。
Hy4 preview 目前有限时优惠活动:Token Plan 用户享刊例价 5 折,活动持续到 10 月 15 日。WorkBuddy 平台上的 Hy4 preview 夜间限时免费也延长到了 10 月 31 日。
关于“Hy4 Pro”:目前无官方确认。腾讯官方材料中只有 Hy4 preview,正式版名称和发布日期均未公布。
有官方信号但还没落地的:三款在路上
DeepSeek V4.1 Pro:官方提过型号,但没有日期
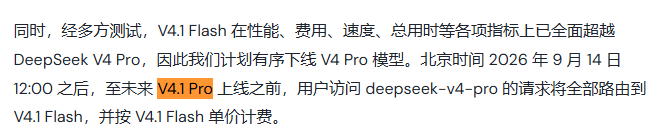
官方信号:DeepSeek 在 9 月 10 日 V4.1 Flash 的发布说明中,写下了“直到 V4.1-Pro 发布”这句话。
这是目前所有传闻中信号最强的一条:型号被官方文字提及,证明在路线图上。但除此之外,没有模型卡、没有 API 端点、没有权重、没有价格。
作为参照,DeepSeek V4.1 Flash 是 552B 参数的 MoE,输入激活 8B、输出激活 16B,原生支持图像理解,1M 上下文,KV Cache 需求降到上一代四分之一。V4.1 Pro 若在这套架构上扩规模,Agent 和复杂编程是主要看点。
但需要注意:V4.1 Pro 已经在 Flash 发布后“迟到”超过一个月。有分析认为,“V4.1 Pro 的 Pro 名称现在已经尾随 Flash 超过一个月,这是关于它时机唯一可衡量的事情,也是停止把它当作即将发布的合理理由”。
Kimi K3.1:API 标识可探测,官方预告已出现
官方信号:开发者发现 kimi-k3-1 标识可通过接口调用,官方开放平台出现 K3.1 预告,标注 1M 上下文。
多名开发者在月之暗面 API 平台后台发现 kimi-k3-1 模型标识,通过了接口探测并可正常调用。Kimi 官方开放平台随后出现 K3.1 预告,支持 1M tokens 上下文窗口。
根据流出的配置信息,K3.1 可能提供 Low、High、Max 三档推理强度,以及 Agent 模式、Swarm 多智能体协作、搜索和批处理等任务模式。当前平台显示的 API 价格与 K3 相同,但不排除是占位符。
但官方尚未正式发布:K3.1 没有独立模型卡或价格条目。上一代 Kimi K3 发布于 2026 年 7 月,总参数 2.8 万亿,拥有 1M 上下文和原生视觉能力。
GLM 5.3-Flash:官方已发布,但“GLM 5.5”零痕迹
官方状态:GLM-5.3-Flash 已于 8 月 26 日发布。GLM 5.5 无任何官方痕迹。
对 Z.ai 官网发布记录、Hugging Face 组织、GitHub 仓库的核查显示,没有任何条目以“GLM 5.5”命名。最新官方发布是 GLM-5.3-Flash(8 月 26 日)和 GLM-5.3(8 月 18 日)。
GLM-5.3-Flash 采用混合线性与稀疏注意力架构,总参数 320B、激活 18B,原生视觉能力支持观察界面和渲染结果,形成代码-浏览器-界面的闭环。在 Artificial Analysis 智能指数上得分 57,每任务成本仅 0.045 美元(折扣后),被称为“之前只在 10 倍成本下才能获得的智能水平”。
关于“万亿参数”的说法:源头是智谱创始人唐杰在一次演讲中提到的目标。但 Z.ai 在 8 月 31 日的财报电话会上直接点名 GLM-6.0 为下一代基础模型,跳过了 5.4 和 5.5。
智谱的公开路线是:继续扩大后训练和 RL 规模,同时推进下一代基座模型。唐杰表示,当前基座参数约 7450 亿,使用周期半年以上,“简单把参数做大,并不是 Scaling 的本质路径”。
只有“一句话书面记录”的:Qwen 4
官方状态:仅确认“正在训练中”。
阿里巴巴 9 月 22 日云栖大会的官方新闻稿中,关于 Qwen 4 的全部书面内容就是一句话:“其下一代模型 Qwen 4 目前正在训练中”。
Qwen 4 Max、Flash、Plus、27B 这四个层级名称,是在会议讲台上口头公布的,未出现在书面新闻稿中,也未附带任何规格说明。
这意味着:没有模型卡、没有权重、没有 API、没有定价、没有上下文窗口、没有参数规模。你目前能实际调用或下载的 Qwen 代际只有 Qwen 3.8,旗舰为 Qwen3.8-Max。
有一个容易搞混的点:搜索中紧挨着 Qwen 4 出现的 “5 万亿到 10 万亿参数”,阿里在新闻稿中明确归于 Qwen 4.5 和 Qwen 5 系列,不是 Qwen 4 本身。
关于 27B 层级:这个层级历史上常以开源权重发布(Qwen3.5-27B 到 Qwen3.8-27B 都存在于 Hugging Face),但 Qwen 4 的这一承诺尚未兑现。
一张图看清官方状态
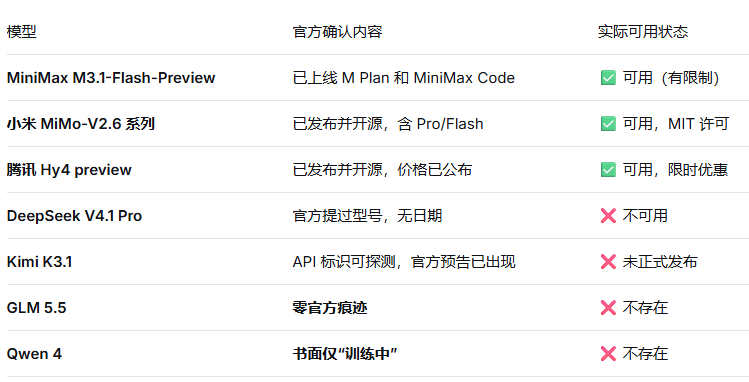
这一轮更新在讲什么
把已经落地的三款放在一起看,趋势很清楚:
第一,1M 上下文正在变成标配。 MiMo-V2.6、Hy4 preview、M3.1-Flash-Preview 都支持 100 万 token。
第二,Agent 和编程是核心战场。 所有新模型的卖点都集中在 Coding Agent、工具调用、长时任务上。
第三,开源和透明在成为差异化武器。 小米用 MIT 许可开源万亿参数模型,还直播训练过程;腾讯把 Hy4 preview 直接开源并公布价格。
写在最后
这份“十月前瞻”清单能在一天内被大量转发,说明社区对国产模型的期待是真实的。但把官方记录翻一遍就会发现:三款已经落地,三款有信号但没发布,一款连官方痕迹都没有。
传闻可以追,但别把传闻当官宣。模型卡、API 价格、开源许可证和可复现的实测,才是最终验证标准。
本文核验时间为 2026 年 10 月 14 日,基于各厂商官网、API 文档及正式新闻稿。
评论
发表评论